MetaServer 3.1(32) : modèles personnalisés, classification plus intelligente, gains opérationnels réels
MetaServer 3.1(32) associe Separate & Classify à Azure AI Document Intelligence et ajoute la prise en charge des modèles personnalisés. Découvrez ce que la version de septembre 2025 change pour les flux de documents à haut volume.
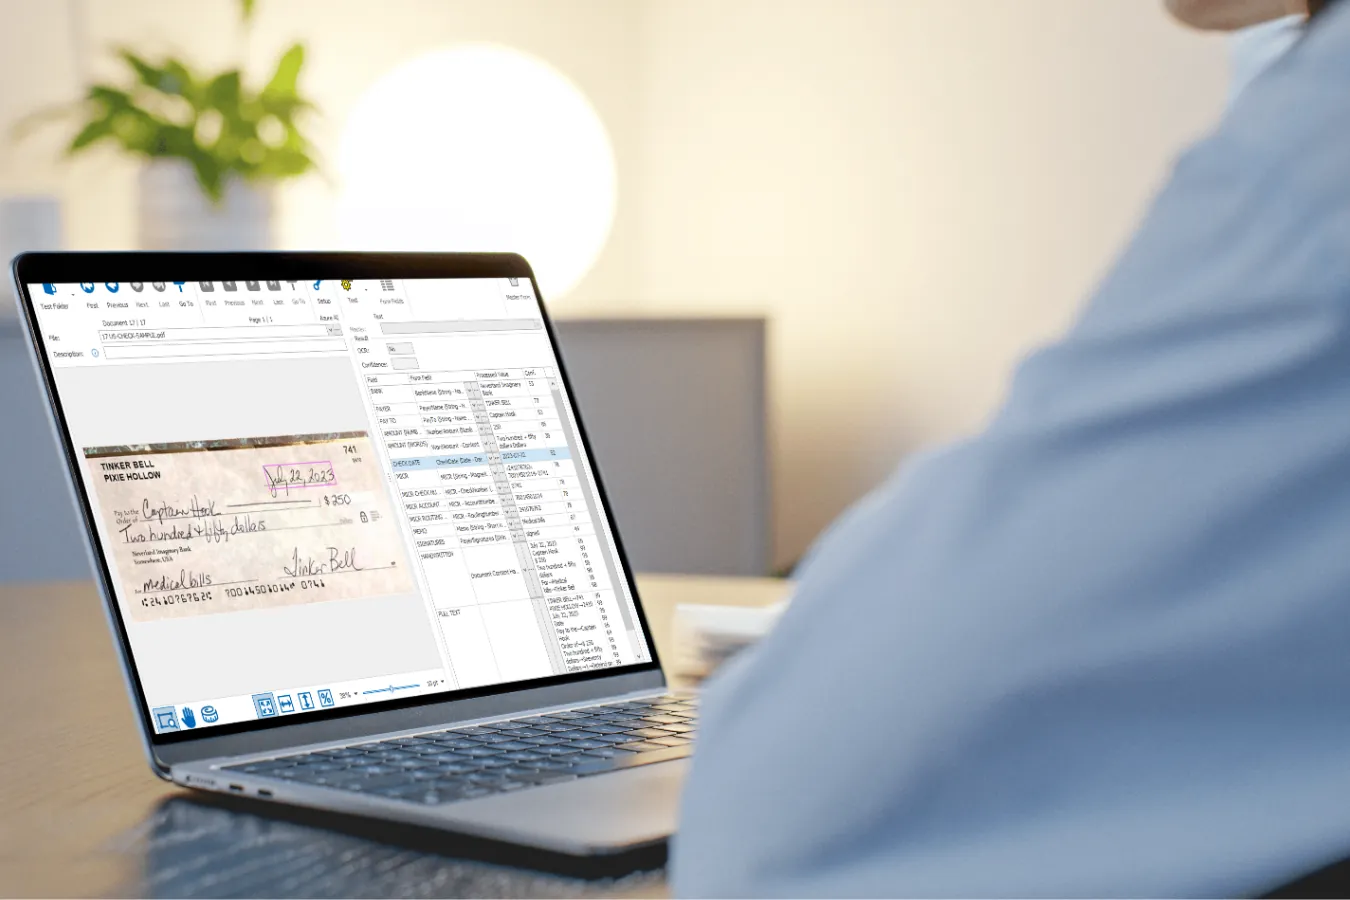
Sortie en septembre 2025, la version MetaServer 3.1(32) apporte une série d'améliorations conçues pour rendre l'automatisation documentaire plus intelligente, plus efficace et bien plus facile à gérer. Loin d'être une simple mise à jour de routine, cette version introduit des optimisations concrètes qui soutiennent directement les équipes dépendant de MetaServer pour la classification, l'extraction et la gestion quotidienne de leurs flux de documents.
Que vous traitiez des lots de documents mixtes, des formulaires complexes ou des charges de travail importantes impliquant plusieurs services, ces nouvelles fonctionnalités vous aident à rationaliser vos processus, à renforcer la précision et à réduire les interventions manuelles.
Une classification documentaire plus intelligente pour les flux à haut volume
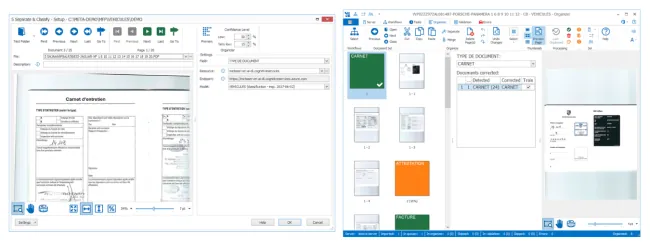
L'un des ajouts les plus marquants est la mise à jour de l'action Separate & Classify, désormais intégrée à Azure AI Document Intelligence - Custom Classification. MetaServer peut séparer automatiquement les documents et leur attribuer le type correct avec un score de confiance. Ces classifications apparaissent visuellement dans l'Organizer grâce à des indicateurs de couleur intuitifs (vert, orange et rouge), permettant aux opérateurs de confirmer les résultats instantanément.
Pour les organisations traitant des ensembles de documents volumineux et variés, tels que des dossiers RH, des demandes d'indemnisation ou des dossiers patients, cela élimine une part importante du tri manuel. Lorsqu'un utilisateur corrige une erreur de classification, MetaServer peut réinjecter cette information dans le modèle, améliorant ainsi la précision au fil du temps. Il s'agit d'une étape concrète vers l'apprentissage continu, sans complexité supplémentaire pour l'opérateur.
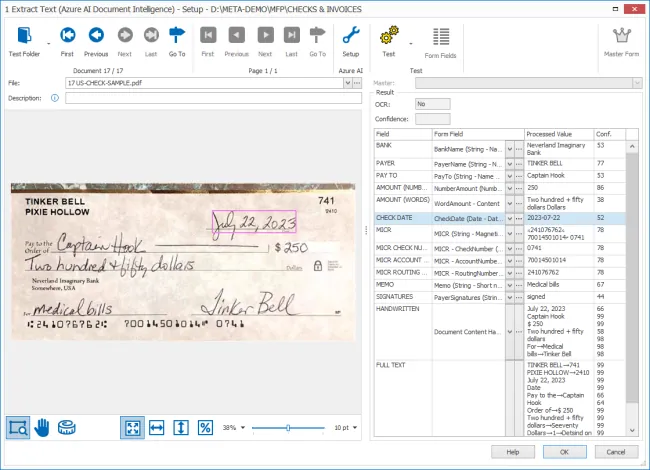
Prise en charge du modèle prédéfini « Check (US) » dans la règle Extract Text (Azure AI Document Intelligence)
MetaServer prend désormais en charge le nouveau modèle prédéfini « Check (US) » au sein de la règle Extract Text (Azure AI Document Intelligence). Il peut également être utilisé pour des chèques non américains. Comme pour tous les autres modèles prédéfinis, aucune formation n'est requise de la part de l'utilisateur. Il vous suffit de mapper les champs souhaités avec les champs de formulaire disponibles.
La seule limite pour les chèques non américains est que la ligne MICR n'est pas détectée automatiquement. Vous pouvez toutefois la retrouver dans le texte intégral en utilisant les règles MetaServer classiques.
Extraction de données sur mesure avec Azure AI Document Intelligence - Modèles d'extraction personnalisés
Les entreprises gèrent souvent des documents qui ne correspondent pas parfaitement à des modèles prédéfinis. Pour répondre à ce besoin, MetaServer prend désormais en charge les modèles d'extraction personnalisés au sein de Azure AI Document Intelligence.
Les utilisateurs peuvent créer et entraîner des modèles d'extraction en téléchargeant un petit échantillon de documents — cinq suffisent — et en marquant les champs qu'ils souhaitent extraire. Une fois le modèle entraîné, les champs peuvent être mappés directement dans les flux de travail MetaServer.
Voici quelques exemples courants :
- Documents de leasing automobile
- Formulaires d'expédition
- Contrats juridiques ou dossiers de contentieux
Modules requis : CB-META-AZDI + CB-META-AZCE
La force de cette mise à jour réside dans son accessibilité : aucune compétence en développement n'est requise. Les équipes peuvent affiner les modèles au fil du temps grâce à un entraînement progressif et s'adapter rapidement aux nouvelles variantes de documents.
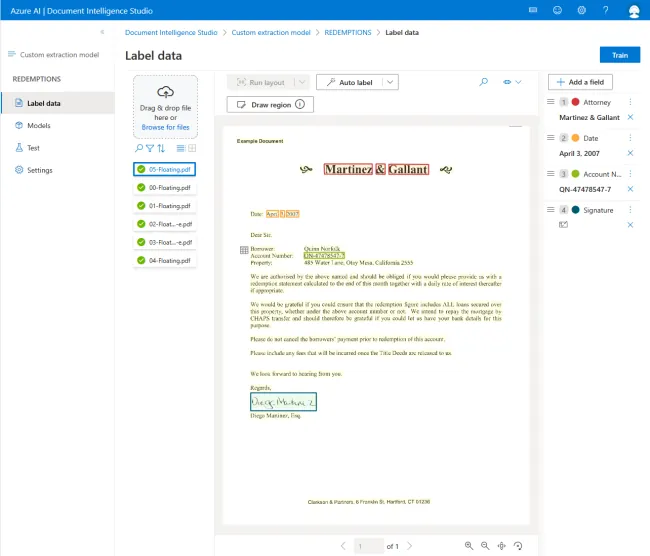
Vous entraînez le modèle d'extraction au sein d'Azure Document Intelligence Studio
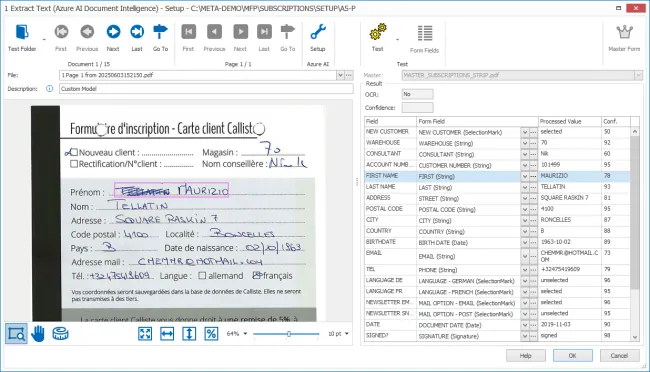
Le modèle d'extraction est appliqué dans MetaServer
Connectivité SharePoint sécurisée avec authentification moderne
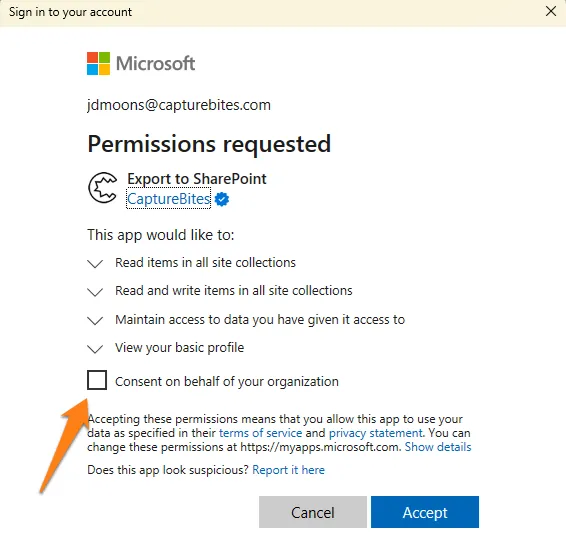
Microsoft a abandonné l'authentification de base, et MetaServer prend désormais entièrement en charge OAuth 2.0 pour SharePoint. Cela garantit un fonctionnement sécurisé, conforme et ininterrompu pour les environnements cloud. La nouvelle configuration nécessite une réauthentification unique, détaillée dans la documentation de CaptureBites.
Contrôle de flux de travail amélioré pour les environnements multi-services
MetaServer introduit deux améliorations qui aident les organisations à gérer plus efficacement les infrastructures partagées :
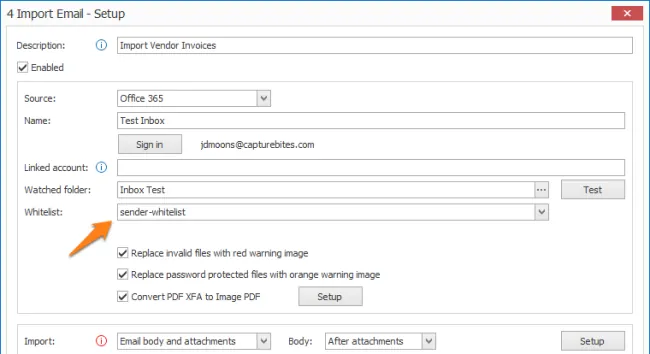
- Liste blanche d'e-mails : seuls les expéditeurs approuvés sont traités, ce qui réduit le bruit et soutient les politiques de conformité.
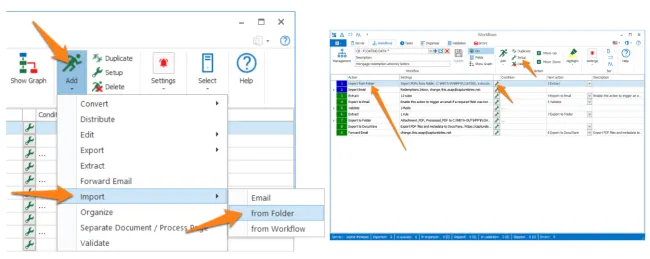
- Limites d'importation par sous-dossier : empêche un service unique de consommer toutes les ressources dans les structures de dossiers partagés, garantissant une répartition équitable et des performances prévisibles.
Ces mises à jour sont particulièrement utiles pour les entreprises où plusieurs équipes numérisent et soumettent des documents dans un système centralisé.
Nouveaux contrôles centralisés pour les administrateurs, moins de configuration manuelle
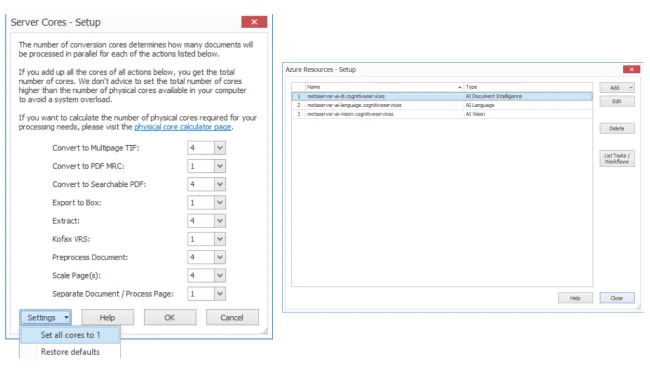
MetaServer centralise désormais deux outils d'administration clés :
- La gestion des cœurs est désormais centralisée dans l'onglet Serveur du client d'administration. Les administrateurs peuvent ajuster le nombre de cœurs de traitement utilisés pour diverses actions sans avoir à configurer chaque élément séparément.
- La gestion des ressources Azure est également centralisée : définissez une clé Azure une seule fois et utilisez-la pour toutes les actions associées. Cela réduit considérablement le temps de configuration et simplifie les mises à jour futures.
Plus d'informations grâce à un meilleur suivi
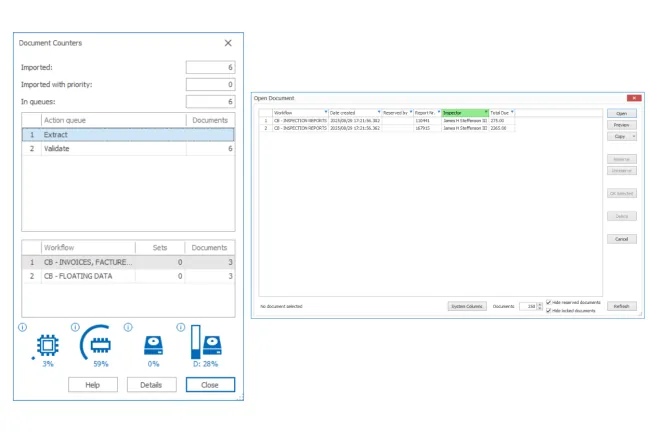
De l'utilisation du processeur aux files d'attente de documents, MetaServer 3.1(32) offre aux administrateurs informatiques une meilleure visibilité sur les performances du système et les tendances d'utilisation :
- Suivi de l'utilisation du processeur avec journalisation automatique lorsque l'utilisation dépasse 100 % pendant des périodes prolongées
- Métriques système en temps réel pour l'utilisation de la mémoire, l'accès au disque, la capacité du disque et les files d'attente de documents
- Indicateurs visuels pour mettre en évidence les seuils de performance (par exemple, utilisation du processeur, de la mémoire et du disque)
- Des alertes proactives permettent d'identifier et de résoudre les problèmes avant qu'ils ne perturbent le traitement
- Réservations de documents par utilisateur, offrant un aperçu de la répartition de la charge de travail
Ces améliorations sont particulièrement précieuses dans les environnements à fort volume, où le maintien des performances et de la stabilité est essentiel.
Une expérience améliorée, du front-end au back-end
De petites améliorations peuvent faire une grande différence au quotidien. Voici quelques points forts :
- Les préférences personnelles (comme la taille de la police et la mise en page) sont désormais enregistrées par utilisateur, et non plus par appareil.
- La vitesse de chargement de la liste des documents est plus rapide et les filtres sont désormais appliqués directement à la liste des documents de l'utilisateur actuel
- La fonction « Rejet » lors de la validation a été étendue pour être également utilisée comme une action « positive », via une icône verte. Cela peut être utile pour envoyer certains documents vers une étape de validation spécifique ou pour mettre à jour un modèle de classification personnalisé. Cette action est également visualisée dans le diagramme de flux de travail.
- Lecture de codes-barres plus précise (jusqu'à 20 % plus rapide) avec une meilleure reconnaissance sous plusieurs angles.
- Les modèles d'IA prédéfinis et personnalisés affichent désormais des informations utiles, telles que les dates d'expiration et les types de champs.
Des corrections de bugs pour un fonctionnement fluide en continu
MetaServer 3.1(32) inclut également une longue liste d'améliorations techniques, allant d'une meilleure gestion des fichiers XFA et des images intégrées aux e-mails, à la correction du formatage CSV, à l'optimisation des exportations de données et à la résolution d'erreurs intermittentes dans les intégrations Azure.
Ces mises à jour garantissent le bon fonctionnement de MetaServer pour tous les types d'utilisation.
Pourquoi cette mise à jour est importante
MetaServer 3.1(32) est bien plus qu'une simple mise à jour incrémentale : c'est une avancée stratégique dans le traitement intelligent des documents. Grâce à de nouveaux outils de classification automatisée, d'entraînement de modèles d'IA personnalisés et de gestion de serveur améliorée, cette version offre aux utilisateurs les moyens de créer des flux de travail non seulement efficaces, mais aussi évolutifs et plus intelligents au fil du temps.
Avancer avec Dyanix
Chez Dyanix, nous savons que même le logiciel le plus puissant ne donne sa pleine mesure qu'avec un support adapté. En tant que distributeur majeur de MetaServer, nous sommes là pour vous aider à tirer le meilleur parti de MetaServer 3.1(32), de la gestion des licences et du déploiement aux solutions sur mesure et à la formation pratique.
Que vous créiez votre premier modèle d'extraction ou de classification personnalisé, que vous optimisiez les performances de votre serveur ou que vous intégriez de nouvelles fonctionnalités, comme l'authentification SharePoint ou la classification de vos documents, notre équipe est prête à vous accompagner à chaque étape.
Prêt à numériser vos documents ?
Nos experts vous accompagnent dans le choix du scanner et des services les mieux adaptés aux besoins de votre organisation.